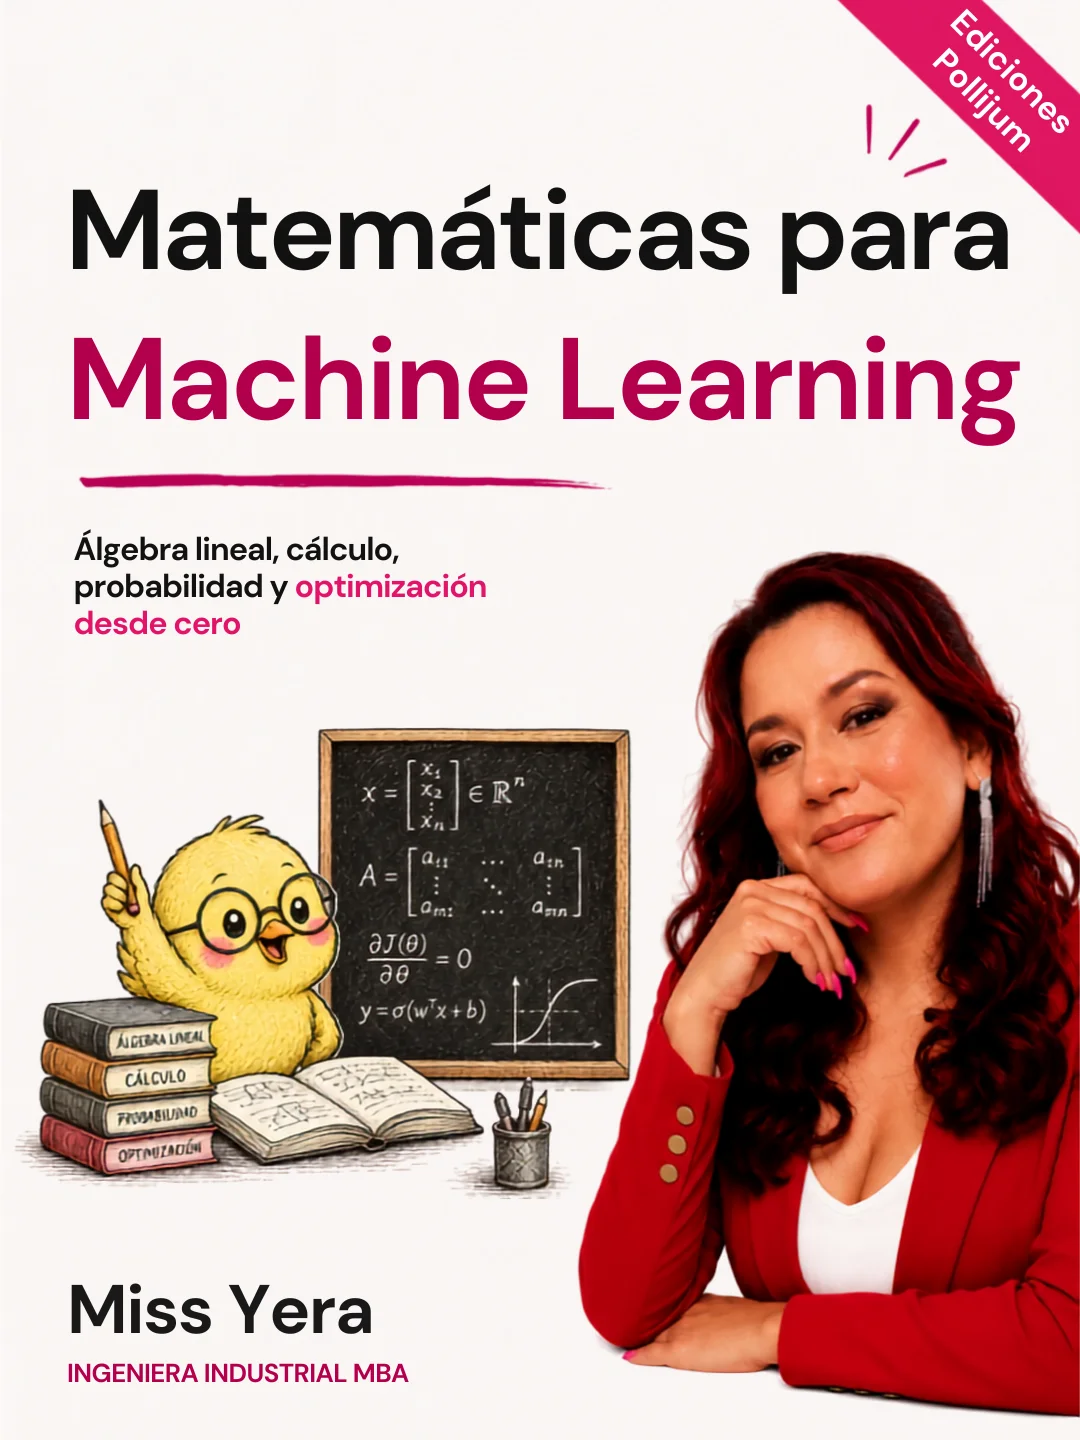
Hola! Este libro nació de una queja 🌸
La queja es mía, y va así.
En mi libro de deep learning hay un capítulo que se llama "Repartir la culpa hacia atrás". Ahí explico la retropropagación, que es lo que hace que una red aprenda. Y para explicarla uso la regla de la cadena.
En mi libro de machine learning hay otro donde agrupamos clientes, y por debajo eso son autovectores.
Conté las veces que mis propios libros usan esta matemática:
| Libro | Cuántas veces aparece |
|---|---|
| Deep learning desde cero | gradiente 97, vector 38, matriz 34, derivada 14, regla de la cadena 13 |
| Machine learning desde cero | matriz 22, PCA 18, optimización 7 |
Y en ningún sitio de mi web decía qué es una derivada. Ni qué es un autovector. Estaba usando el piso sin haberlo construido 🙃
Eso es este libro.
Para quién es
Para ti si te pasa alguna:
- Entiendes qué hace un modelo pero no qué pasa por dentro, y te molesta.
- Abriste un paper, viste una fórmula con una sigma y cerraste la pestaña.
- Estás en mis libros de ML o DL y hay párrafos que te suenan a magia.
- Vas a postular a una maestría y en la malla dice "Matemática para machine learning" y no sabes qué te va a caer.
Y también para ti si la matemática del colegio te dejó un mal recuerdo. Este libro no empieza por definiciones: empieza abriendo un archivo de ventas 🐣
Qué NO es
No es un curso de matemática pura. No hay demostraciones por inducción ni teoremas que no vayas a usar. Si un concepto no aparece en mis otros libros, no está acá.
Tampoco repite lo que ya tienes. La probabilidad y las distribuciones están enteras en Estadística desde cero y no las vuelvo a contar.
Lo que lo hace distinto
Que los otros siete libros están al lado.
Cada capítulo termina apuntando al capítulo concreto que ya usaba eso. La regla de la cadena manda a "Repartir la culpa hacia atrás". Los autovectores mandan a "Agrupar clientes sin decirle cómo". No es "aprende álgebra lineal", es "esto es lo que estaba pasando en el capítulo que leíste".
Un libro de matemática suelto no puede hacer eso 💛
El índice
Álgebra lineal, o por qué tus datos ya eran una matriz
- Tus datos ya eran una matriz y nadie te lo había dicho
- Un vector no es una flecha, es una fila de tu tabla
- Sumar y escalar, que ya es media predicción
- La operación que hace todo: el producto punto
- Multiplicar matrices, y qué está calculando de verdad
- Transpuesta e inversa, y por qué casi nunca se invierte
- Norma y distancia: cómo mide un modelo que se equivocó
- Rango e independencia: por qué dos columnas parecidas rompen tu modelo
Geometría y descomposiciones
- Proyecciones: lo que hace la regresión lineal por dentro
- Autovalores y autovectores, sin empezar por el determinante
- Qué es PCA, y ya lo usaste
- Qué es SVD, la que sostiene medio machine learning
Cálculo, lo que de verdad hace falta
- Qué mide una derivada, con un caso tuyo
- Derivadas parciales y el gradiente: hacia dónde subir
- La regla de la cadena es la retropropagación
- Jacobiana y hessiana, lo justo
Optimización
- Descenso de gradiente, a mano y después con NumPy
- Por qué a veces no converge: tasa, mínimos locales y convexidad
- Regularización vista como geometría: por qué L1 hace ceros y L2 no
- El proyecto entero
- Referencias y dónde seguir
Cómo leerlo
Los 22 capítulos están publicados y el orden importa: cada uno se apoya en los anteriores. Empezar por el 15 porque te interesa la regla de la cadena es perder el tiempo, y no lo digo por pedante, lo digo porque el 15 usa el producto punto del 4 sin volver a explicarlo.
Si tienes prisa y solo quieres una cosa concreta, los cuatro que más se consultan sueltos son 4, 9, 18 y 20. Los tres últimos igual te van a mandar hacia atrás, y está bien que lo hagan.
Cada capítulo arranca reabriendo el archivo, así que puedes abrir cualquiera y correrlo sin haber corrido los otros 🌸
Qué necesitas antes de empezar
Python básico, y con el nivel de Python desde cero te sobra. Nada más.
De matemática, nada. En serio nada: el capítulo 1 empieza abriendo un CSV. Esto es literalmente todo lo que hace falta instalar:
pip install numpy pandas matplotlib
Tres paquetes. NumPy es el que hace las cuentas, pandas el que abre el archivo y matplotlib el que dibuja. Nada más en todo el libro.
La trampa
Una analista quiere el promedio de cada columna de su tabla de ventas para un reporte. Escribe esto, sale un número por venta, y como salen números lo pega en el reporte.
medias = X.mean(axis=1)
print(medias[:3])

[164.79 179.3   56.28]
Qué está mal
El eje está cambiado. Con axis=1 promedia cada FILA, o sea que suma unidades con soles y con estrellas de satisfacción y divide entre tres. Ese 164.79 no es una cantidad de nada. Lo que quería es axis=0, que da un número por columna: 11.68 unidades, 803.39 soles y 3.02 de satisfacción. El código no da error, y ese es el problema.
Comprueba que vas bien
Comprueba que lo tienes
Tienes una matriz X con forma (2238, 3). ¿Qué te devuelve X[:, 1]?
- La segunda fila, o sea una venta entera
- La segunda columna, o sea los 2.238 montos
- El número que está en la fila 1, columna 1
- Un error, porque la columna 1 no existe
Preguntas frecuentes
¿Necesito saber matemática del colegio para empezar?
No. El capítulo 1 empieza abriendo un archivo de ventas y contando filas y columnas. Lo único que hace falta es Python básico, porque todo se explica ejecutando código y mirando la salida.
¿Este libro repite lo de Estadística desde cero?
No. La probabilidad, las distribuciones y las pruebas de hipótesis están enteras en ese libro y aquí no se vuelven a contar. Este cubre lo otro: álgebra lineal, cálculo y optimización, que es lo que machine learning y deep learning usan sin explicar.
¿Para qué me sirve saber esto si las librerías ya lo hacen?
Para cuando algo no funciona. Un modelo que no converge, una columna que rompe el entrenamiento o un gradiente que se desvanece no se arreglan leyendo la documentación: se arreglan entendiendo qué está pasando por debajo. Mientras todo va bien, la librería basta.
¿Hace falta leer los otros libros antes?
Solo Python desde cero. Machine learning y deep learning se pueden leer antes, después o en paralelo: este libro apunta a capítulos concretos de esos dos, así que si ya los leíste vas a reconocer de qué se estaba hablando.
¿Cuánto tiempo me va a tomar?
Los 22 capítulos suman unas 31.000 palabras y unos 63 ejercicios. Leídos seguidos son cuatro o cinco horas; hechos de verdad, con los cuadernos abiertos y el código corriendo, calcula entre tres y cuatro semanas a un capítulo cada dos días. No corras: la gracia de este libro es que cada número lo ejecutes tú y veas salir el mismo.
¿El libro es gratis?
Sí, entero y sin registro. No hay correo que dejar, no hay capítulo que se desbloquee pagando y no hay versión premium escondida. Igual que los otros siete libros del sitio, que llevan años así. Lo que sí te pido es que si te sirve se lo pases a alguien más, porque eso es lo único que hace que esto siga teniendo sentido para mí 💛
¿Qué incluye el libro Matemática para machine learning de Miss Yera?
22 capítulos y 63 ejercicios con su solución. Cubre el álgebra lineal, el cálculo y la optimización que de hecho usan los libros de machine learning y deep learning, y nada más. Se lee entero en la web, sin registro y sin pagar nada, y cada capítulo enlaza al anterior y al siguiente para que se pueda seguir en orden.
¿Vale la pena el libro Matemática para machine learning de Miss Yera?
No hace falta que me creas: está abierto, entra al primer capítulo y júzgalo tú. Lo que lo distingue de un curso grabado es que el código publicado se ejecutó antes de publicarse y su salida está ahí para que compares, y que los 63 ejercicios traen solución comprobada. Si después de dos capítulos no te sirve, no sigas.
¿Para quién está pensado el libro Matemática para machine learning de Miss Yera?
Para quien se traba con las fórmulas de los otros libros y no quiere estudiarse una carrera de matemáticas para seguir. No pide requisitos previos ni instalar nada complicado: se puede leer en la web y los ejercicios se abren en Colab desde el navegador.
¿Qué aprenderé con el libro Matemática para machine learning de Miss Yera?
Terminas entendiendo qué calcula un producto punto, qué hace una derivada dentro del descenso de gradiente y por qué tus datos ya eran una matriz. Son 22 capítulos y cada uno se lee en una sentada y se practica en una tarde. Cuando lo acabes, lo que sigue en el camino es volver a Machine learning desde cero o a Deep learning desde cero con las fórmulas ya entendidas.
¿El libro Matemática para machine learning de Miss Yera es realmente gratuito?
Sí, y sin la trampa habitual: no hay que registrarse, no piden correo, no hay una parte de pago después. Los 22 capítulos completos están en la web y los cuadernos de ejercicios se abren en Colab. Lo que sí se cobra son los cursos en vivo, que son otra cosa.
¿El libro Matemática para machine learning de Miss Yera incluye ejercicios y soluciones?
Sí, 63 ejercicios repartidos en los 22 capítulos, y todos con solución. Se ejecutan en Colab con el código al lado, para que veas el número y no solo la fórmula. La solución viene comprobada, no escrita de memoria.
¿Dónde puedo descargar el libro Matemática para machine learning de Miss Yera?
No hay PDF que descargar y es a propósito: el libro vive en la web, en missyera.com/guias/matematica-para-machine-learning/, porque así se corrige y se amplía sin que a nadie le quede una versión vieja en el escritorio. Lo que sí se descarga son los cuadernos de ejercicios, que se abren directamente en Colab.
¿Qué opiniones hay sobre el libro Matemática para machine learning de Miss Yera?
Prefiero no ponerte reseñas que no puedas verificar. Lo que sí puedes comprobar tú misma en dos minutos: entra a cualquier capítulo y mira si el código trae publicada la salida con la que se comparó, y si los ejercicios tienen la solución. Eso dice más de un libro técnico que cualquier testimonio.
Los 22 capítulos
Se leen en orden. Cada uno supone el anterior.
- 1 Tus datos ya eran una matriz y nadie te lo había dicho Qué es una matriz, qué es una fila, qué es una columna, y por qué el archivo de ventas que abres todos los días ya es una.
- 2 Un vector no es una flecha, es una fila de tu tabla Qué es un vector de verdad en machine learning, por qué el dibujo de la flecha te va a estorbar, y la diferencia entre fila y columna.
- 3 Sumar y escalar, que ya es media predicción Las dos únicas operaciones que necesitas para entender qué hace un modelo lineal por dentro, con la tabla de ventas de siempre.
- 4 La operación que hace todo: el producto punto Qué es el producto punto, por qué se llama así, y por qué es literalmente la línea que hay dentro de cualquier modelo lineal.
- 5 Multiplicar matrices, y qué está calculando de verdad Por qué la multiplicación de matrices es esa y no la obvia, cómo leer las formas de un vistazo, y por qué el orden sí importa.
- 6 Transpuesta e inversa, y por qué casi nunca se invierte Qué hace la transpuesta, qué es la inversa, por qué existe la identidad y por qué en código de verdad se usa solve y no inv.
- 7 Las matrices con nombre propio, y por qué les pusieron uno Cuadrada, diagonal, simétrica, identidad y ortogonal. Qué tienen de especial y dónde te las vas a encontrar trabajando.
- 8 Norma y distancia: cómo mide un modelo que se equivocó Qué es la norma de un vector, la diferencia entre L1 y L2, y por qué el error de un modelo es literalmente una distancia.
- 9 Rango e independencia: por qué dos columnas parecidas rompen tu modelo Qué es el rango de una matriz, qué es la independencia lineal, y cómo detectar las columnas que sobran antes de que revienten algo.
- 10 Proyecciones: lo que hace la regresión lineal por dentro Qué es proyectar un vector sobre otro, por qué lo que sobra siempre queda perpendicular, y por qué una regresión es exactamente eso.
- 11 Autovalores y autovectores, sin empezar por el determinante Qué es una dirección que una matriz no gira, qué mide el número que la acompaña, y por qué eso es lo que hay debajo de PCA.
- 12 Qué es PCA, y ya lo usaste Análisis de componentes principales explicado como lo que es: mirar la misma tabla desde las direcciones que los autovectores encontraron.
- 13 Qué es SVD, la que sostiene medio machine learning La descomposición en valores singulares explicada desde PCA, por qué funciona con matrices que no son cuadradas y para qué se usa de verdad.
- 14 Qué mide una derivada, con un caso tuyo La derivada sin límites ni epsilones: a cuánto sube el error por cada paso, calculada sobre el ajuste de un peso de verdad.
- 15 Derivadas parciales y el gradiente: hacia dónde subir Qué es una derivada parcial, qué es el gradiente, y por qué apunta hacia arriba cuando lo que quieres es bajar.
- 16 La regla de la cadena es la retropropagación Qué dice la regla de la cadena, cómo se aplica eslabón por eslabón sobre una regresión logística, y por qué eso es exactamente lo que hace una red.
- 17 Jacobiana y hessiana, lo justo Qué son las derivadas de segundo orden, qué mide la curvatura, y por qué saberlo explica que el entrenamiento vaya lento.
- 18 Descenso de gradiente, a mano y después con NumPy El algoritmo con el que se entrena casi todo, escrito en cuatro líneas y corrido sobre la tabla de ventas hasta llegar al óptimo exacto.
- 19 Por qué a veces no converge: tasa, mínimos locales y convexidad Los tres motivos por los que un entrenamiento no llega, con el número exacto que separa la tasa que funciona de la que explota.
- 20 Regularización vista como geometría: por qué L1 hace ceros y L2 no Ridge y lasso explicados desde las normas L1 y L2, con la diferencia geométrica que hace que una ponga ceros y la otra no.
- 21 El proyecto entero Los veinte capítulos aplicados de corrido a un problema: desde abrir el archivo hasta interpretar los coeficientes, en diez pasos.
- 22 Referencias y dónde seguir De dónde salen las ideas de este libro, qué leer después, y qué usar para practicar.
Los 63 ejercicios de este libro están también en 21 cuadernos que se abren en Colab sin instalar nada. Escribes tu respuesta y el cuaderno te dice si te salió 💛
El libro entero en PDF
Con el índice, los 22 capítulos y las soluciones de todos los ejercicios al final de cada uno. Te lo mando a tu correo 💛
1,7 MB · Se lee igual y gratis acá, siempre.
¿Quieres llevarlo más lejos?
Esta guía te deja operando. El curso te deja diseñando, midiendo y gobernando sistemas de IA que trabajan solos.
Ver los cursos